Domain vorsagen.de kaufen?
Wir ziehen mit dem Projekt
vorsagen.de um.
Sind Sie am Kauf der Domain
vorsagen.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain vorsagen.de kaufen?
Wie funktioniert Speech to Text?
Speech to Text funktioniert, indem gesprochene Wörter mithilfe von Spracherkennungssoftware in Text umgewandelt werden. Dabei werden die Audiosignale des gesprochenen Textes analysiert und in Text umgewandelt. Die Software erkennt dabei Sprachmuster, Wörter und Sätze, um sie korrekt zu transkribieren. Dieser Prozess basiert auf komplexen Algorithmen und künstlicher Intelligenz, die kontinuierlich verbessert werden, um die Genauigkeit der Umwandlung zu erhöhen. Das Ergebnis ist ein geschriebener Text, der die gesprochene Sprache möglichst genau wiedergibt. **
Wie benutze ich Text to Speech?
Um Text-to-Speech zu verwenden, benötigen Sie zunächst eine Software oder eine App, die diese Funktion unterstützt. Öffnen Sie dann die gewünschte Textdatei oder geben Sie den Text ein, den Sie vorgelesen haben möchten. Wählen Sie die gewünschte Stimme und Sprache aus, und starten Sie die Wiedergabe. Sie können auch die Geschwindigkeit und Lautstärke der Sprachausgabe anpassen. Text-to-Speech ist eine nützliche Funktion für Menschen mit Sehbehinderungen oder für diejenigen, die sich Texte lieber vorlesen lassen möchten. **
Ähnliche Suchbegriffe für Dynamik
Top-Angebote
Produkte zum Begriff Dynamik:
-
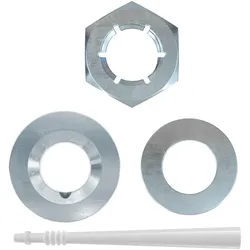
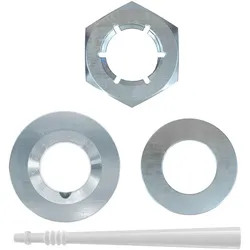
Dynamik Set M20 RDas fischer Dynamik Set ist die universelle Systemkomponente für dynamische Belastungen. Durch die im Set enthaltene Verfüllscheibe wird eine lückenlose Verfüllung des Ringspaltes ermöglicht und somit eine sichere Lastübertragung gewährleistet. Das Set kann in Vor- und Durchsteckmontage genutzt werden. Technische Daten: Außen-Ø: 50 [mm] Dicke: 13 [mm] Min. Dicke des Anbauteils: 20 [mm] Passend zu: FAZ II Plus M20 R330,59 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Dynamik Set M24 RDas fischer Dynamik Set ist die universelle Systemkomponente für dynamische Belastungen. Durch die im Set enthaltene Verfüllscheibe wird eine lückenlose Verfüllung des Ringspaltes ermöglicht und somit eine sichere Lastübertragung gewährleistet. Das Set kann in Vor- und Durchsteckmontage genutzt werden. Technische Daten: Außen-Ø: 55 [mm] Dicke: 17 [mm] Min. Dicke des Anbauteils: 24 [mm] Passend zu: FAZ II Plus M24 R447,64 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Solid State Logic Fusion - Dynamik-ProzessorAnaloger Stereo-Prozessor zur professionellen Klangbearbeitung beim Mastering oder im Mix-Bus5 separaten Schaltungen zur Signalbearbeitung; die einzeln; in beliebiger Kombination oder alle gleichzeitig verwendet werden könnenVintage Drive – eine nicht lineare Sättigungsschaltung für kontrollierten Overload mit harmonischen StukturenViolet EQ – ein zweibandiger Shelving Filter mit vier schaltbaren FrequenzenHF Compressor – mit variabler Threshold und X-Over Regelung (3-20 kHz) für zusätzliche Transparenz bis hin zu einem BandsättigungseffektStereo Image – für Räumlichkeitseffekte im Mono/Stereobild TransformerTransformer – eine "Übertragerschaltung"; die dem Signal durch harmonische Komponenten im Tiefenbereich und leichte Phasenverschiebungen in den höheren Frequenzen mehr Präsenz hinzufügtBypass-SchalterSchaltbarer HPFSchaltbarer Stero-Insert (XLR)XLR-Buchsen für alle Ein- und Ausgänge (2 x XLR In; 2 x XLR Out)Leistungsaufnahme: 50 W max (integrietes Netzteil)Hochwertige Ver1489,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter


-
Kennt jemand ein gutes Text-to-Speech-Programm?
Ja, es gibt verschiedene gute Text-to-Speech-Programme auf dem Markt. Einige beliebte Optionen sind Google Text-to-Speech, Amazon Polly und Microsoft Azure Text-to-Speech. Diese Programme bieten eine natürliche Sprachausgabe und können in verschiedenen Anwendungen wie Sprachassistenten, Vorleseprogrammen oder Barrierefreiheitstools verwendet werden. **
-
Gibt es ein Open-Source-Text-to-Speech-Modell?
Ja, es gibt mehrere Open-Source-Text-to-Speech-Modelle. Ein bekanntes Beispiel ist das Tacotron-Modell, das von Google entwickelt wurde. Es ermöglicht die Generierung von natürlicher Sprache aus Text und ist in der Open-Source-Community weit verbreitet. Es gibt auch andere Modelle wie WaveNet und DeepVoice, die ebenfalls Open-Source sind. **
-
Wie lautet der deutsche Text-to-Speech-Stimme VBS?
Die deutsche Text-to-Speech-Stimme VBS steht für "Voices for Blind and Sight-impaired" und ist eine speziell entwickelte Stimme für blinde und sehbehinderte Menschen. Sie ermöglicht es ihnen, geschriebenen Text in gesprochene Sprache umzuwandeln und so Informationen zu erhalten. **
-
Welche guten Text-to-Speech-Seiten kann ich finden?
Es gibt viele gute Text-to-Speech-Seiten, die eine natürliche und hochwertige Sprachausgabe bieten. Einige beliebte Optionen sind Google Text-to-Speech, Amazon Polly, Microsoft Azure Speech und IBM Watson Text to Speech. Diese Dienste ermöglichen es Benutzern, Text in verschiedenen Sprachen in eine Sprachausgabe umzuwandeln. **

Wie funktioniert die Text-to-Speech-Funktion auf TikTok?
Die Text-to-Speech-Funktion auf TikTok verwendet eine Spracherkennungssoftware, um den eingegebenen Text in Sprache umzuwandeln. Die Software analysiert den Text und generiert dann eine Sprachausgabe, die im Video abgespielt wird. Die Benutzer können aus verschiedenen Sprachoptionen wählen und die Geschwindigkeit der Sprachausgabe anpassen. **
Was ist die beste KI für Text-to-Speech?
Es gibt viele gute KI-Modelle für Text-to-Speech, aber einige der bekanntesten und am weitesten entwickelten sind Tacotron 2, WaveNet und Deep Voice. Diese Modelle haben eine hohe Qualität und Natürlichkeit in der Generierung von Sprache und werden von vielen Unternehmen und Entwicklern verwendet. Es ist jedoch wichtig zu beachten, dass die "beste" KI für Text-to-Speech von den spezifischen Anforderungen und Präferenzen abhängt, da verschiedene Modelle unterschiedliche Stärken und Schwächen haben können. **
Top-Angebote
Produkte zum Begriff Dynamik:
-
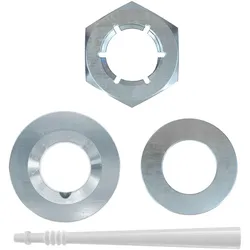
Dynamik Set M24Das fischer Dynamik Set ist die universelle Systemkomponente für dynamische Belastungen. Durch die im Set enthaltene Verfüllscheibe wird eine lückenlose Verfüllung des Ringspaltes ermöglicht und somit eine sichere Lastübertragung gewährleistet. Das Set kann in Vor- und Durchsteckmontage genutzt werden. Technische Daten: Außen-Ø: 54 [mm] Dicke: 17 [mm] Min. Dicke des Anbauteils: 24 [mm] Passend zu: FAZ II Plus M24110,21 €*Versand: 5,90 €Sichere Weiterleitung zum Anbieter
-
Hera Dynamik-Controller 20805005011Ausführung=dynamischGeeignet für Außengebrauch=neinDimmung 0-10 V=neinDimmung 1-10 V=neinDimmung DALI=neinDimmung DSI=neinDimmung DMX=neinDimmung Potentiometer (geräteintegriert)=neinDimmung LineSwitch=neinDimmung herstellerspezifisch=jaDimmung Netzspannungsmodulation=neinDimmung Phasenabschnitt=neinDimmung Phasenanschnitt=neinDimmung programmierbar=neinDimmung RF=neinDimmung Sine Wave Reduction=neinDimmung Touch and Dim=neinDimmung Zigbee=neinDimmung mit Push-button=neinKonstant-Lichtstrom-Regelung=neinOhne Dimmfunktion=neinGehäuse=ohne (Platinenmontage)Geeignet für Konstantstrom=neinGeeignet für Konstantspannung=jaAusgangsspannung=24 VAusgangsstrom=42..2000 mAGeeignet für Gleichspannung (Primärseite)=jaAusgangsleistung=1..48 WLeistungsaufnahme=48 WSchutzart (IP)=IP20Schutzklasse=IIILänge=50 mmBreite=10 mmHöhe=10 mmBedienung über Bluetooth=neinKompatibel mit Apple HomeKit=neinKompatibel...13,55 €*Versand: 5,99 €Sichere Weiterleitung zum Anbieter
-
Dynamik Set M20 RDas fischer Dynamik Set ist die universelle Systemkomponente für dynamische Belastungen. Durch die im Set enthaltene Verfüllscheibe wird eine lückenlose Verfüllung des Ringspaltes ermöglicht und somit eine sichere Lastübertragung gewährleistet. Das Set kann in Vor- und Durchsteckmontage genutzt werden. Technische Daten: Außen-Ø: 50 [mm] Dicke: 13 [mm] Min. Dicke des Anbauteils: 20 [mm] Passend zu: FAZ II Plus M20 R330,59 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Dynamik Set M24 RDas fischer Dynamik Set ist die universelle Systemkomponente für dynamische Belastungen. Durch die im Set enthaltene Verfüllscheibe wird eine lückenlose Verfüllung des Ringspaltes ermöglicht und somit eine sichere Lastübertragung gewährleistet. Das Set kann in Vor- und Durchsteckmontage genutzt werden. Technische Daten: Außen-Ø: 55 [mm] Dicke: 17 [mm] Min. Dicke des Anbauteils: 24 [mm] Passend zu: FAZ II Plus M24 R447,64 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Wie funktioniert Speech to Text?
Speech to Text funktioniert, indem gesprochene Wörter mithilfe von Spracherkennungssoftware in Text umgewandelt werden. Dabei werden die Audiosignale des gesprochenen Textes analysiert und in Text umgewandelt. Die Software erkennt dabei Sprachmuster, Wörter und Sätze, um sie korrekt zu transkribieren. Dieser Prozess basiert auf komplexen Algorithmen und künstlicher Intelligenz, die kontinuierlich verbessert werden, um die Genauigkeit der Umwandlung zu erhöhen. Das Ergebnis ist ein geschriebener Text, der die gesprochene Sprache möglichst genau wiedergibt. **
-
Wie benutze ich Text to Speech?
Um Text-to-Speech zu verwenden, benötigen Sie zunächst eine Software oder eine App, die diese Funktion unterstützt. Öffnen Sie dann die gewünschte Textdatei oder geben Sie den Text ein, den Sie vorgelesen haben möchten. Wählen Sie die gewünschte Stimme und Sprache aus, und starten Sie die Wiedergabe. Sie können auch die Geschwindigkeit und Lautstärke der Sprachausgabe anpassen. Text-to-Speech ist eine nützliche Funktion für Menschen mit Sehbehinderungen oder für diejenigen, die sich Texte lieber vorlesen lassen möchten. **
-
Kennt jemand ein gutes Text-to-Speech-Programm?
Ja, es gibt verschiedene gute Text-to-Speech-Programme auf dem Markt. Einige beliebte Optionen sind Google Text-to-Speech, Amazon Polly und Microsoft Azure Text-to-Speech. Diese Programme bieten eine natürliche Sprachausgabe und können in verschiedenen Anwendungen wie Sprachassistenten, Vorleseprogrammen oder Barrierefreiheitstools verwendet werden. **
-
Gibt es ein Open-Source-Text-to-Speech-Modell?
Ja, es gibt mehrere Open-Source-Text-to-Speech-Modelle. Ein bekanntes Beispiel ist das Tacotron-Modell, das von Google entwickelt wurde. Es ermöglicht die Generierung von natürlicher Sprache aus Text und ist in der Open-Source-Community weit verbreitet. Es gibt auch andere Modelle wie WaveNet und DeepVoice, die ebenfalls Open-Source sind. **
Ähnliche Suchbegriffe für Dynamik
-
Solid State Logic Fusion - Dynamik-ProzessorAnaloger Stereo-Prozessor zur professionellen Klangbearbeitung beim Mastering oder im Mix-Bus5 separaten Schaltungen zur Signalbearbeitung; die einzeln; in beliebiger Kombination oder alle gleichzeitig verwendet werden könnenVintage Drive – eine nicht lineare Sättigungsschaltung für kontrollierten Overload mit harmonischen StukturenViolet EQ – ein zweibandiger Shelving Filter mit vier schaltbaren FrequenzenHF Compressor – mit variabler Threshold und X-Over Regelung (3-20 kHz) für zusätzliche Transparenz bis hin zu einem BandsättigungseffektStereo Image – für Räumlichkeitseffekte im Mono/Stereobild TransformerTransformer – eine "Übertragerschaltung"; die dem Signal durch harmonische Komponenten im Tiefenbereich und leichte Phasenverschiebungen in den höheren Frequenzen mehr Präsenz hinzufügtBypass-SchalterSchaltbarer HPFSchaltbarer Stero-Insert (XLR)XLR-Buchsen für alle Ein- und Ausgänge (2 x XLR In; 2 x XLR Out)Leistungsaufnahme: 50 W max (integrietes Netzteil)Hochwertige Ver1489,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Warm Audio WA-1B - Dynamik-ProzessorOptischer Vollröhren-Kompressor mit Ausgangsübertragern Der WA-1B ist die akkurate Nachbildung eines skandinavischen Kompressors der Weltklasse; der sanfte röhrenoptische Wärme mit präziser Steuerung kombiniert. Wie das Original; das von Produzenten und Toningenieuren von Chris Lord-Alge bis Rick Rubin bevorzugt wird; liefert der WA-1B die gesuchte "forgiving" Kompression der röhrenoptischen Schaltung mit der Geschwindigkeit und Kontrolle; die man eher mit moderner Dynamikverarbeitung verbindet. Der WA-1B wurde von Hand verdrahtet um den originalgetreuen Schaltkreis authentisch nachzubilden. Die Kombination aus Großkern-Übertragern von Lundahl Sweden; ausgewählten Röhren von JJ und Tung-Sol sowie einem erstklassigen Opto-Koppler sind Garant für einen ultraschnellen und präzisen Sound; ohne dabei die authentische analoge Wärme zu opfern. 1 Kanal999,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
SITWELL Dynamik M Halblehner - Luxus BürostuhlSITWELL Dynamik M Halblehner - Luxus Bürostuhl - günstig kaufen Produktmerkmale: Das Bürostuhl Modell Dynamik M Halblehner verwöhnt Sie mit einer extra komfortablen Ergo - Sacral - Polsterung. Die Rückenlehne ist ergonomisch aufgebaut und richtet Ihre Körperhaltung durch eine mittig verlaufende, dezente Ergo - Sacral - Polsterung konstant auf. Im Bereich der Lendenwirbel ist eine Stützpolsterung integriert, die Ihrer Wirbelsäule speziell an langen Arbeitstagen zusätzlichen Halt gewährt und zugleich...835,04 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Wie lautet der deutsche Text-to-Speech-Stimme VBS?
Die deutsche Text-to-Speech-Stimme VBS steht für "Voices for Blind and Sight-impaired" und ist eine speziell entwickelte Stimme für blinde und sehbehinderte Menschen. Sie ermöglicht es ihnen, geschriebenen Text in gesprochene Sprache umzuwandeln und so Informationen zu erhalten. **
-
Welche guten Text-to-Speech-Seiten kann ich finden?
Es gibt viele gute Text-to-Speech-Seiten, die eine natürliche und hochwertige Sprachausgabe bieten. Einige beliebte Optionen sind Google Text-to-Speech, Amazon Polly, Microsoft Azure Speech und IBM Watson Text to Speech. Diese Dienste ermöglichen es Benutzern, Text in verschiedenen Sprachen in eine Sprachausgabe umzuwandeln. **
-
Wie funktioniert die Text-to-Speech-Funktion auf TikTok?
Die Text-to-Speech-Funktion auf TikTok verwendet eine Spracherkennungssoftware, um den eingegebenen Text in Sprache umzuwandeln. Die Software analysiert den Text und generiert dann eine Sprachausgabe, die im Video abgespielt wird. Die Benutzer können aus verschiedenen Sprachoptionen wählen und die Geschwindigkeit der Sprachausgabe anpassen. **
-
Was ist die beste KI für Text-to-Speech?
Es gibt viele gute KI-Modelle für Text-to-Speech, aber einige der bekanntesten und am weitesten entwickelten sind Tacotron 2, WaveNet und Deep Voice. Diese Modelle haben eine hohe Qualität und Natürlichkeit in der Generierung von Sprache und werden von vielen Unternehmen und Entwicklern verwendet. Es ist jedoch wichtig zu beachten, dass die "beste" KI für Text-to-Speech von den spezifischen Anforderungen und Präferenzen abhängt, da verschiedene Modelle unterschiedliche Stärken und Schwächen haben können. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.